Accueil › Blog › Le signal commun du robots.txt
BlogGoogle et OpenAI vont suivre un signal commun
Ce que ça change pour une TPE
Le 30 octobre 2026, Google et OpenAI ont annoncé qu'ils prendraient en compte une même ligne du robots.txt pour refuser l'entraînement des IA. Faut-il l'ajouter à votre site ? Pour la plupart des petites entreprises, pas maintenant. Voici pourquoi.
Par Charles Bapst · publié le 31 octobre 2026
En bref : Google et OpenAI ont annoncé le 30 octobre 2026 un signal commun, à placer dans le robots.txt, pour dire à plusieurs fournisseurs d'IA en une fois : « pas d'entraînement sur mes pages ». Il n'est pas encore en service. Il ne concerne que l'entraînement, pas la recherche. Si vous voulez être trouvé et cité, vous n'avez rien à ajouter aujourd'hui : relisez plutôt votre robots.txt pour vérifier que les robots de recherche passent.
En 20 s : votre site et votre fiche apparaissent-ils ? Testez-les maintenant.
Cet article est une actualité : il résume l'annonce et ce qu'elle implique pour une petite entreprise. Pour la méthode complète, voyez mon guide sur les robots d'IA et ce qu'il faut bloquer ou non, et pour les bases, le fichier robots.txt.
Ce qui a été annoncé
Jusqu'ici, refuser l'entraînement obligeait à écrire une règle par fournisseur : GPTBot pour OpenAI, Google-Extended pour Google, et ainsi de suite. Le nouveau signal remplace cette liste par un seul nom, valable chez tous les fournisseurs qui l'adoptent.
- Google annonce son intention de le prendre en charge et vise 2027, avec d'autres fournisseurs d'IA. Ses réglages propres restent valables.
- OpenAI annonce qu'il le respectera et vise « les prochains mois ». Ses réglages actuels continuent eux aussi de s'appliquer.
- Le texte est un brouillon déposé à l'IETF le 30 octobre 2026 par Kevin Kelley (Anthropic), en lien avec le groupe de travail sur les préférences d'usage par les IA. C'est un document de travail, pas encore un standard : il peut changer.
À quoi ressemble le signal
Le brouillon n'invente aucune syntaxe nouvelle : il réutilise les groupes habituels du robots.txt, avec un nom réservé. Voici l'exemple qu'il donne, un refus sur tout le site sauf un dossier (exemple à lire, pas à copier) :
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
Deux précisions du texte comptent pour vous :
- la ligne
User-agent: *ne vaut pas pour ce signal. Un fichier sans groupe dédié n'exprime aucune préférence, ni pour ni contre ; - le signal n'est pas une consigne d'exploration : il dit ce que vous acceptez comme usage, pas quelles pages un robot peut visiter.
Entraînement n'est pas recherche
C'est la confusion à éviter. L'entraînement, c'est le fait d'utiliser un contenu pour modifier les paramètres d'un modèle d'IA générative : c'est la définition reprise par le brouillon. Être cité dans une réponse passe le plus souvent par un autre chemin, la recherche en direct. Le signal ne dit rien de la recherche.
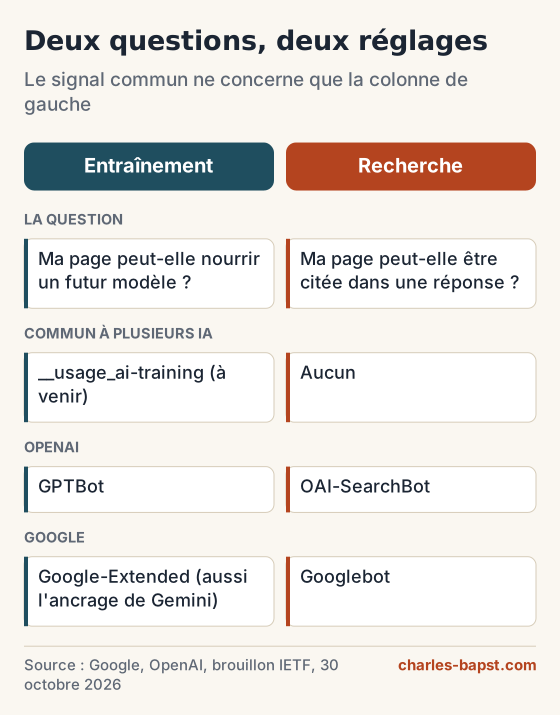
Chez OpenAI, les deux réglages sont indépendants : GPTBot pour l'entraînement, OAI-SearchBot pour l'affichage dans la recherche de ChatGPT. Bloquer le second retire votre site des réponses de cette recherche. Chez Google, Google-Extended n'a pas d'effet sur la présence dans la recherche Google et n'est pas un signal de classement.
Le point à surveiller chez Google
Google écrit que, si un site refuse l'entraînement par le signal commun sans mentionner Google-Extended, il prévoit de lire ce refus comme un refus de Google-Extended. Or ce jeton règle aussi l'ancrage, c'est-à-dire l'apport de contenus de l'index aux réponses du modèle. Google ajoute que les sites qui autorisent expressément Google-Extended peuvent apparaître dans les réponses des applications Gemini et recevoir des clics.
Ma lecture, à confirmer quand Google publiera le détail : un refus global pourrait aussi vous priver de cette visibilité dans Gemini. L'inverse a un prix : autoriser Google-Extended, c'est aussi accepter l'entraînement de Gemini, puisque le même jeton couvre les deux. Le choix n'est donc pas gratuit.
Que faire si vous êtes une TPE
Pour un plombier, un garage ou un restaurant, le contenu du site n'est pas ce qu'on vend : c'est ce qui fait venir les clients. Refuser l'entraînement a donc peu d'intérêt, et ce n'est pas le sujet urgent. Mon conseil, valable pour le référencement pour plombier comme pour le référencement pour restaurant :
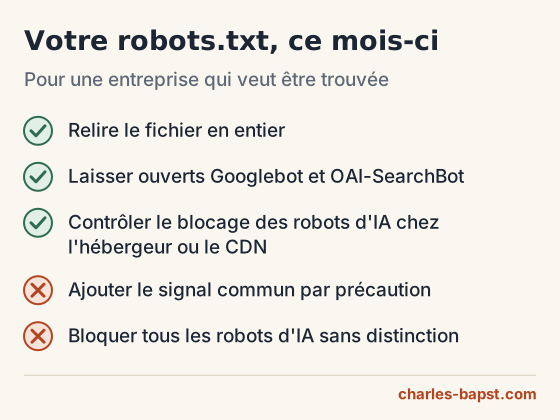
- N'ajoutez rien pour l'instant. Le signal n'est pas en service et son texte peut encore bouger.
- Relisez votre robots.txt en tapant l'adresse de votre site suivie de
/robots.txt. Un vieuxDisallow: /vous coûte bien plus cher que n'importe quel entraînement. - Vérifiez que Googlebot et OAI-SearchBot passent. Regardez aussi les réglages de votre hébergeur ou de votre CDN : le blocage des robots d'IA peut s'y activer sans que le fichier change.
- Méfiez-vous des extensions et des outils de site qui proposeront ce réglage en un clic : ne changez rien sur un simple conseil automatique.
Vous vendez du contenu (formations, données, articles payants) ? La question se pose vraiment : le signal vous simplifiera la vie le jour où il sera en service. Décidez alors page par page, et gardez ouverts les robots de recherche.
Si vous voulez savoir où en est votre site, le test gratuit mesure sa vitesse et son SEO technique. Pour un suivi, je travaille comme consultant SEO dans l'Ain, par exemple comme consultant SEO à Bourg-en-Bresse, et à distance : les formules d'accompagnement détaillent ce qui est compris.
Questions fréquentes
Dois-je ajouter ce signal à mon robots.txt dès maintenant ?
Non. Google vise une prise en charge en 2027 et OpenAI « dans les prochains mois » : le texte reste un brouillon de travail. Pour une entreprise qui cherche des clients, l'ajouter aujourd'hui n'apporte rien de concret.
Refuser l'entraînement me retire-t-il de Google ?
Non. Google traitera le refus comme un refus de Google-Extended, et sa documentation indique que ce jeton n'a pas d'effet sur la présence dans la recherche Google et n'est pas un signal de classement.
Refuser l'entraînement me retire-t-il de ChatGPT ?
Pas de sa recherche, d'après les règles actuelles d'OpenAI : GPTBot sert à l'entraînement, OAI-SearchBot à l'affichage dans la recherche de ChatGPT, et OpenAI annonce que ces contrôles continuent de s'appliquer.
Si je ne fais rien, que se passe-t-il ?
D'après le brouillon, un fichier sans groupe dédié au signal n'exprime aucune préférence : la ligne User-agent: * ne compte pas pour lui. Vos réglages actuels, robot par robot, continuent de s'appliquer.
Sources
- Google Search Central, Supporting a shared AI training control for websites, 30 octobre 2026.
- OpenAI, Making it easier for websites to express AI training preferences, 30 octobre 2026.
- IETF, Machine-Readable Training Preference Signal, brouillon de travail, version 00 du 30 octobre 2026.
- Google, documentation des robots, section Google-Extended, et OpenAI, documentation des robots, consultées le 31 octobre 2026.
À lire aussi : les robots d'IA, faut-il les bloquer ?, le robots.txt, le fichier llms.txt, d'où viennent les sources des IA et le référencement IA.
Votre fiche apparaît-elle ? Vérifiez en 20 s
Le test gratuit de votre site : le résultat s'affiche à l'écran, puis je vous écris la suite.
Vous voulez savoir ce que ça coûte ? Voir les formules et les prix.
Canes Domum, pension canine dans l'Ain, partie de zéro en mars 2025 : 214 appels depuis sa fiche Google en 19 mois (mars 2025 à septembre 2026). Source : sa fiche Google, chiffres publiés avec l'accord de sa gérante. Voir le cas